
多视角推理蒸馏(LLM-MRD)与可审计生成式评审系统(DeepReviewer 2.0)深度拆解
对比大模型落地的两条互补路径:如何用 Qwen2.5-VL 离线多视角分析结合 MLP 残差校准与温度缩放 KL 蒸馏,将推理能力压入 358M 学生模型实现 17.2 ms 独立推理(LLM-MRD,DASFAA 2026 Oral);以及如何通过主张-证据-风险台账、PASA 可比性门控与导出预算校验构建可审计的同行评审 Agent(DeepReviewer 2.0)。
FOLLOW THIS THREAD
Notes on this topic
3 篇公开笔记,沿着这个标签慢慢读。
对比大模型落地的两条互补路径:如何用 Qwen2.5-VL 离线多视角分析结合 MLP 残差校准与温度缩放 KL 蒸馏,将推理能力压入 358M 学生模型实现 17.2 ms 独立推理(LLM-MRD,DASFAA 2026 Oral);以及如何通过主张-证据-风险台账、PASA 可比性门控与导出预算校验构建可审计的同行评审 Agent(DeepReviewer 2.0)。
基于 Qwen2.5 完整复现 Instruct SFT → Bradley-Terry DPO 两阶段后训练管线:通过 3 随机种子消融 LoRA Rank、学习率与数据规模(GSM8K +12.73pp),实现免双倍权重的动态 Adapter 切换 DPO 训练,并定量揭示偏好对齐对确定性数学推理的对齐税效应。
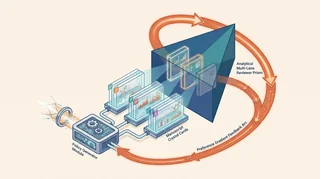
区分推理时 Agent 编排与模型后训练,并拆解 CycleResearcher 的领域 SFT、生成式 Reward Model、Iterative SimPO 和评测风险。