
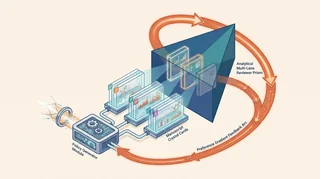
从 DeepReviewer 2.0 到 CycleResearcher:科研 Agent 如何真正做 Post-training
区分推理时 Agent 编排与模型后训练,并拆解 CycleResearcher 的领域 SFT、生成式 Reward Model、Iterative SimPO 和评测风险。
FOLLOW THIS THREAD
Notes on this topic
1 篇公开笔记,沿着这个标签慢慢读。
区分推理时 Agent 编排与模型后训练,并拆解 CycleResearcher 的领域 SFT、生成式 Reward Model、Iterative SimPO 和评测风险。