
多约束生产级 Agent 系统实践:两阶段工具路由、DAG 局部重规划与轨迹级评测闭环
围绕跨境酒旅等强耦合多约束业务场景,拆解向量 Top-K 召回 + LLM 精排 + 跨语言实体链接与 Schema 门控(96%+ 调用合法率)、基于状态机的 DAG 局部子图重规划、Observation 冗余裁剪(节省 40% Token),以及从线上失败恢复轨迹构造 SFT/DPO 偏好对的评测与训练闭环。
FOLLOW THIS THREAD
Notes on this topic
4 篇公开笔记,沿着这个标签慢慢读。
围绕跨境酒旅等强耦合多约束业务场景,拆解向量 Top-K 召回 + LLM 精排 + 跨语言实体链接与 Schema 门控(96%+ 调用合法率)、基于状态机的 DAG 局部子图重规划、Observation 冗余裁剪(节省 40% Token),以及从线上失败恢复轨迹构造 SFT/DPO 偏好对的评测与训练闭环。
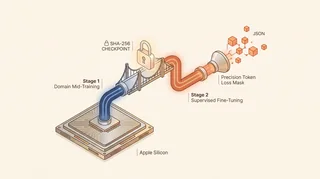
用 Qwen3 0.6B Base 和 MLX 完成领域持续训练与监督微调,记录数据划分、聊天模板、损失掩码、数值稳定性修复和独立测试结果。
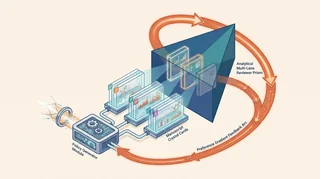
区分推理时 Agent 编排与模型后训练,并拆解 CycleResearcher 的领域 SFT、生成式 Reward Model、Iterative SimPO 和评测风险。
结合生产级多约束 Agent 与超 100K Token 科研智能体实践,系统拆解长程会话中的上下文膨胀与注意力稀释问题:涵盖 Observation 结构化剪枝(降低约 40% Token 开销)、滚动工作摘要、向量检索长期记忆及 Prefix Cache 友好的上下文组装。