
大模型后训练偏好对齐实录:Qwen2.5 SFT 多维消融、动态参考 DPO 与对齐税(Alignment Tax)量化分析
基于 Qwen2.5 完整复现 Instruct SFT → Bradley-Terry DPO 两阶段后训练管线:通过 3 随机种子消融 LoRA Rank、学习率与数据规模(GSM8K +12.73pp),实现免双倍权重的动态 Adapter 切换 DPO 训练,并定量揭示偏好对齐对确定性数学推理的对齐税效应。
FOLLOW THIS THREAD
Notes on this topic
3 篇公开笔记,沿着这个标签慢慢读。
基于 Qwen2.5 完整复现 Instruct SFT → Bradley-Terry DPO 两阶段后训练管线:通过 3 随机种子消融 LoRA Rank、学习率与数据规模(GSM8K +12.73pp),实现免双倍权重的动态 Adapter 切换 DPO 训练,并定量揭示偏好对齐对确定性数学推理的对齐税效应。
用一次 CPU SGD 更新检查 LoRA 初始化、冻结基座与合并等价,再分别记录均匀 4-bit 存储字节数和量化误差。
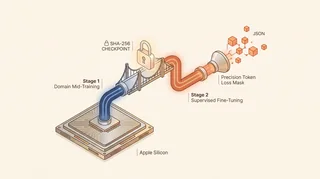
用 Qwen3 0.6B Base 和 MLX 完成领域持续训练与监督微调,记录数据划分、聊天模板、损失掩码、数值稳定性修复和独立测试结果。