
本篇对照课程官网的 Introduction to ML Systems 整理,是个人配套 CPU 实验,不是课程官方作业。脚本编号是练习顺序,不对应课程讲次。
前几篇一直在补 PyTorch 基础。到了这一步,我在学习聊天里问:现在是不是偏离 15-779 的主线了?随后把重点接回了系统问题:同一个网络执行了哪些操作,时间花在哪里,代码的组织方式又怎样影响执行开销。
课程安排中的 Introduction to ML Systems 配有第 2 讲课件,阅读材料包括 TensorFlow 和 PyTorch 两篇系统论文。本篇先围绕已经熟悉的两层网络做三个小实验:22_profile_forward.py、23_profile_batching.py、24_batch_size_sweep.py。
这些脚本在本机执行,并在整理时独立复跑。本文的 batch size 数据来自附件中保存的原始 JSON,对应本机固定环境下的实测快照。
先固定模型和输入#
这次不训练网络,直接观察前向计算。模型结构仍然是:
输入 → Linear(1, 8) → ReLU → Linear(8, 1) → 输出
对于一批 1000 个样本,张量形状依次为:
[1000, 1] → [1000, 8] → [1000, 8] → [1000, 1]
第一层有 1 × 8 + 8 = 16 个参数,第二层有 8 × 1 + 1 = 9 个参数,总共只有 25 个。这是一个刻意保留的小模型,便于观察调用开销,不代表真实大模型的计算规模。
脚本设置了 torch.manual_seed(0),每种推理方式复用相同的模型参数和输入。参数没有经过训练,所以这里不讨论预测是否接近某个目标函数;要检查的是,不同执行方式是否计算了相同的结果。
用 Profiler 看一次前向计算#
22_profile_forward.py 先预热 10 次,再记录一次完整的前向计算:
with torch.no_grad():
    for _ in range(10):
        model(x)

    with profile(activities=[ProfilerActivity.CPU]) as prof:
        prediction = model(x)

print(prof.key_averages().table(
    sort_by="self_cpu_time_total",
    row_limit=20,
))
输出除了 linear 和 relu,还有 addmm、转置、广播、复制等操作。本次环境中,几个主要事件的调用次数是:
| Profiler 事件 | 次数 | 对应的计算 |
|---|---|---|
aten::linear | 2 | 两层线性层 |
aten::addmm | 2 | 当前线性层执行中的矩阵乘法与相加 |
aten::relu | 1 | 中间的激活函数 |
aten::clamp_min | 1 | 当前 ReLU 执行中的下界截断 |
表里的行有嵌套关系。一层 Linear 内部可以调用 addmm,这两个名字不代表网络又多了一层。
读时间列时也要区分:Self CPU 不含子算子的时间,CPU total 包含子算子的时间。把所有行的 CPU total 直接相加,会重复计算嵌套调用。这一点在 PyTorch 官方 Profiler 教程中也有解释。
这次用 Profiler 确认操作和调用次数;速度比较放到 Profiler 外进行,避免将记录开销混入基准测量。
同样的 1000 个样本,为什么调用次数差这么多#
23_profile_batching.py 比较两种写法:
def predict_one_by_one():
    outputs = []
    for i in range(x.shape[0]):
        outputs.append(model(x[i:i + 1]))
    return torch.cat(outputs, dim=0)

def predict_batch():
    return model(x)
x[i:i + 1] 保留了 [1, 1] 的批次形状。逐个预测调用模型 1000 次,整批预测调用模型 1 次;两种方式都完整处理 1000 个样本。
先比较结果,再看性能:
torch.allclose(single_output, batch_output, atol=1e-6)
本次输出近似一致,最大绝对误差为 2.9802322387695312e-08。浮点运算的组织方式变化后,结果可以有很小的末位差异。
| 操作 | 逐个预测 | 整批预测 |
|---|---|---|
aten::linear | 2000 | 2 |
aten::addmm | 2000 | 2 |
aten::relu | 1000 | 1 |
aten::slice | 1000 | 0 |
aten::cat | 1 | 0 |
模型有两层 Linear,所以逐个执行时是 1000 × 2 = 2000 次,整批执行时是 1 × 2 = 2 次。整批运算每次处理更多数据,样本数并没有减少,同时省掉了大部分 Python 循环、分发和切片开销。
这个脚本的计时在 Profiler 外单独进行:每组完整执行 10 遍,先求每遍的平均耗时,再取 7 组结果的中位数。调用次数只对一次完整处理进行记录,不把预热和计时重复次数混在里面。
再把 batch size 拆成多个档位#
只比较“1 个”和“1000 个”还看不到中间变化。24_batch_size_sweep.py 固定总样本数为 1000,扫描:
1、4、16、64、128、256、1000
每一档都使用同一个函数:
def predict_in_batches(batch_size):
    outputs = []
    for start in range(0, sample_count, batch_size):
        outputs.append(model(x[start:start + batch_size]))
    return torch.cat(outputs, dim=0)
这里是便于阅读的写法,完整脚本从命令行参数读取 sample_count。包括 batch_size=1000 在内,每一档都有切片和一次最终拼接,因此比第 23 个脚本的直接 model(x) 多了一点工作。
总样本数为 、batch size 为 时,批次数是:
这个两层网络应当执行 2K 次 linear、K 次 relu。完整脚本对这些次数做了断言,也检查了最后一批和输出总样本数。
例如 B=16 时,前 62 批各有 16 个样本,最后还剩 8 个,所以共有 63 批,linear 调用 126 次。不能直接用 1000 // 16 丢掉尾批。
原始测量结果#
本次扫描使用 macOS arm64、Python 3.11.15、PyTorch 2.14.1、CPU、float32,固定一个 CPU 计算线程。每档均关闭梯度记录,输出与整批参考值通过 rtol=1e-5、atol=1e-6 的近似一致性检查。
计时使用 torch.utils.benchmark.Timer(..., num_threads=1).blocked_autorange(min_run_time=0.2)。它通过分块重复运行获得测量值,并摊薄计时器调用的开销。表中的时间是完整处理全部 1000 个样本的中位耗时。
| Batch size | 批次数 | 最后一批 | Linear 调用 | 全部样本耗时 / ms |
|---|---|---|---|---|
| 1 | 1000 | 1 | 2000 | 8.1494 |
| 4 | 250 | 4 | 500 | 2.1457 |
| 16 | 63 | 8 | 126 | 0.5378 |
| 64 | 16 | 40 | 32 | 0.1390 |
| 128 | 8 | 104 | 16 | 0.0724 |
| 256 | 4 | 232 | 8 | 0.0385 |
| 1000 | 1 | 1000 | 2 | 0.0130 |
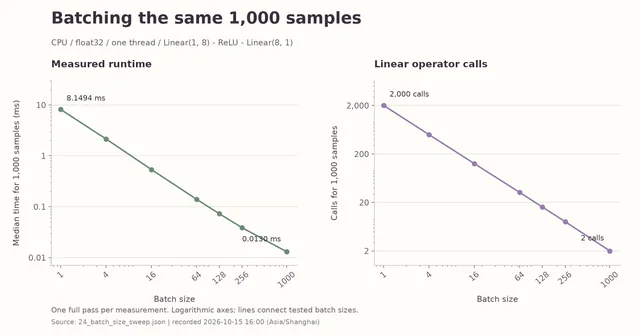
图中的点直接读取 results/24_batch_size_sweep.json,可打开大图查看坐标。连线只连接已测量的档位,不表示中间每个 batch size 都做过测量。原始文件还保留了中位数、四分位距、重复测量信息、环境和脚本 SHA-256。
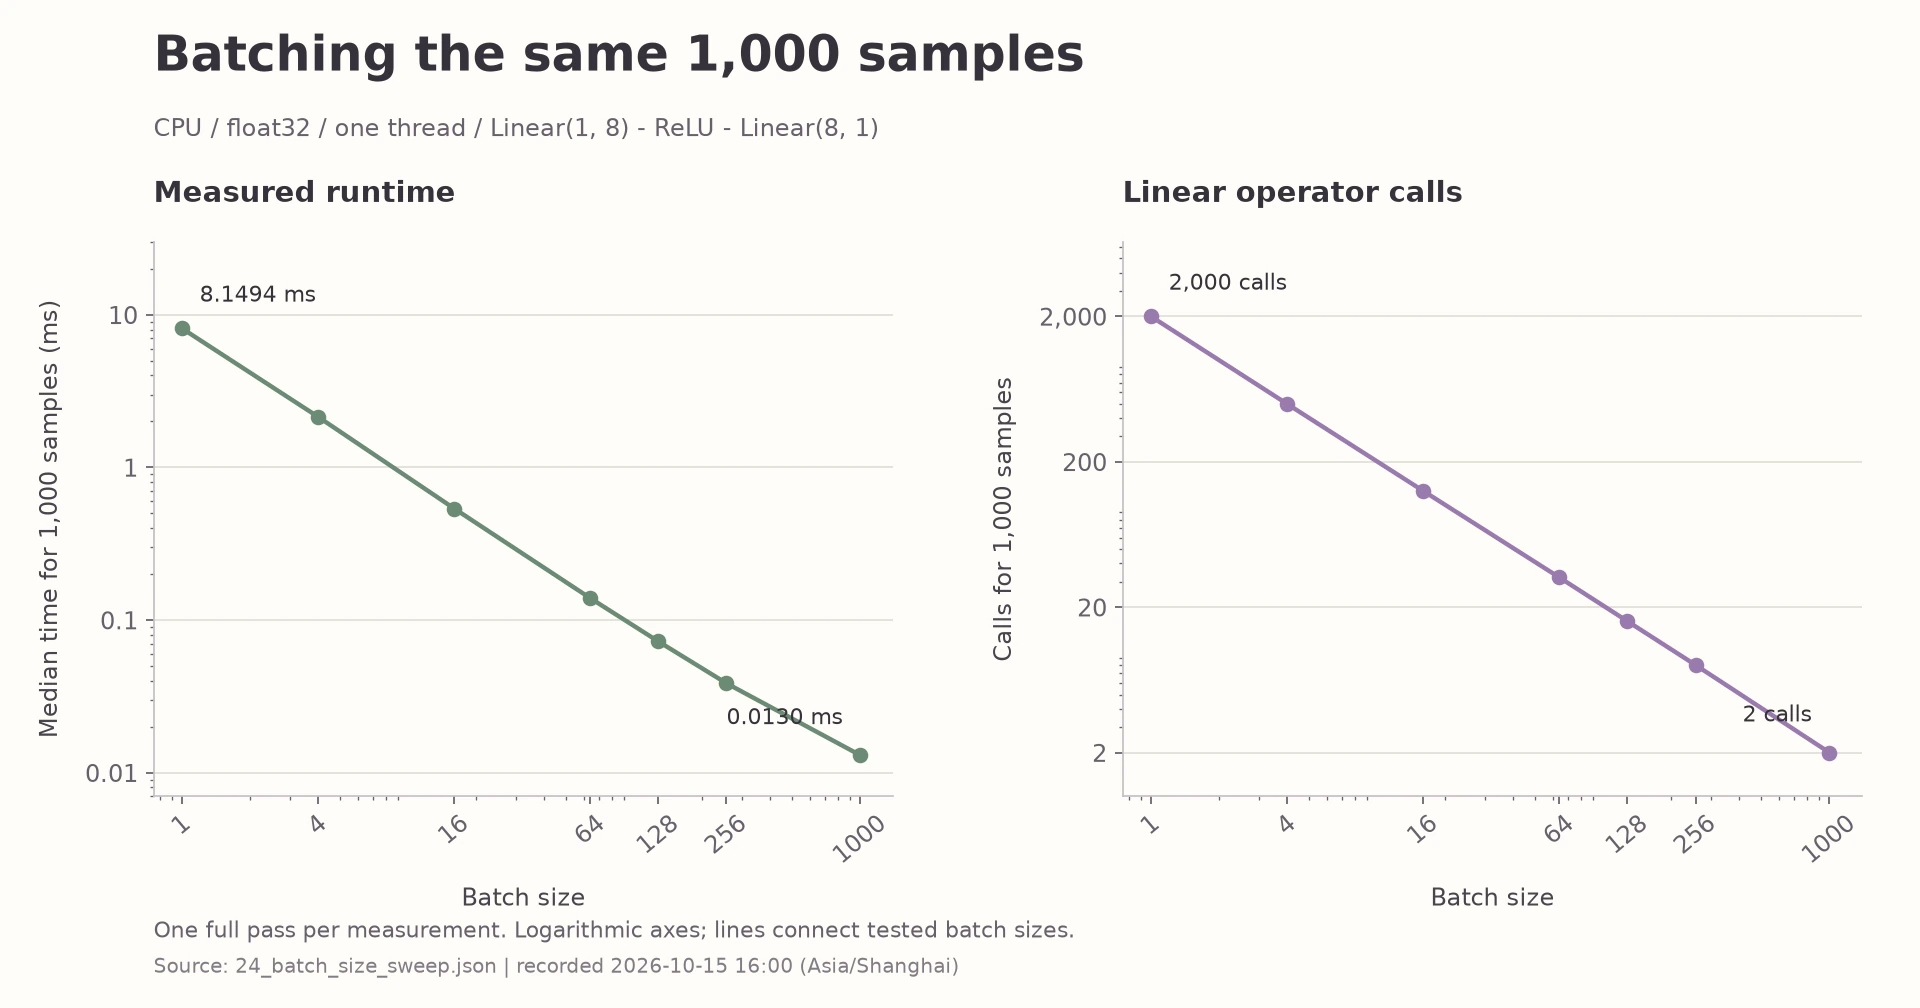
这一组数据里,batch size 增大后,模型调用次数和总耗时都明显下降。这个网络只有 25 个参数,每次计算很小,调用和数据组织开销值得关注。
计时范围包含 Python 分批循环、切片、前向计算和一次 cat;不包含创建模型和输入、检查结果、Profiler 或写文件。因此它描述的是“这 1000 个已准备好的样本怎样更快算完”,没有测请求到达、等待凑批或在线服务的响应延迟。
这次结果能说明什么#
批量计算仍然处理相同的样本,只是把许多小调用合成了较少的大调用。本次算子计数和耗时测量支持这一点。
但不能据此断言 batch size 总是越大越好。这里没有改变模型大小,没有测 GPU、显存、并发请求或延迟约束。后续换成更大的网络时,需要重新测量计算量、内存占用和吞吐之间的关系。
第 23 个脚本与第 24 个脚本的计时协议也不同:前者整批分支直接调用模型,后者所有档位统一切片和拼接,并固定一个线程。两份脚本适合回答各自的对照问题,不应拿其中某两个时间直接计算跨实验的加速比。
整理时复跑了三份脚本,输出一致性与调用次数全部通过;另外用 7 个样本检查了 batch size 为 1、3、10 的情况,确认尾批和“大于总样本数的一批”也能完整处理输入。耗时会随系统负载变化,文章保留原始测量值。
代码、数据和复现#
ZIP 包含三份脚本、依赖文件、运行说明,以及原始的 results/24_batch_size_sweep.json。运行前两个脚本:
python3.11 -m venv .venv
.venv/bin/python -m pip install -r requirements.txt
.venv/bin/python 22_profile_forward.py
.venv/bin/python 23_profile_batching.py
重新扫描时,把结果写到一个新文件,便于与随附的原始记录比较:
.venv/bin/python 24_batch_size_sweep.py \
  --output results/24_batch_size_sweep-rerun.json
也可以明确指定样本数和档位:
.venv/bin/python 24_batch_size_sweep.py \
  --samples 7 --batch-sizes 1 3 10 \
  --output results/24_batch_size_sweep-remainder.json
参考资料:CMU 课程安排、Introduction to ML Systems 课件、PyTorch Profiler 教程、PyTorch Benchmark API。
评论
评论由 GitHub Discussions 驱动,使用 GitHub 账号登录即可留言。