
GPU Architecture & CUDA Programming 的个人配套练习。首次记录为 CPU 索引演示;后续在单卡 GPU 环境补入原生 CUDA 编译、运行与 memcheck,以及 Triton 向量加法实测。
上一节从算子调用次数解释批量推理。这次把视角往下移一层:一个 CUDA kernel 中,线程怎样知道自己应该处理哪个元素?
本篇对应 25_cuda_indexing.py,先用 10 个元素的向量加法拆开索引公式。原始记录和整理时的复跑都来自 Mac CPU,不包含 GPU 性能测量。课件依据是原课 GPU/CUDA 幻灯片中的线程组织部分。
每个线程负责一个加法#
这次的输入和目标很简单:
a = [ 0,  1,  2, ...,  9]
b = [10, 10, 10, ..., 10]
c = [10, 11, 12, ..., 19]
每个输出都满足 c[i] = a[i] + b[i],不同元素之间不依赖彼此。先采用一个线程负责一个元素的分工。
CUDA 把线程放在线程块(block)里,再把多个线程块组织为 grid。这个例子只用一维配置,涉及四个名字:
| CUDA C++ 内置变量 | 在本例中的含义 |
|---|---|
threadIdx.x | 线程在自己 block 内的编号,从 0 开始 |
blockIdx.x | block 在 grid 内的编号,从 0 开始 |
blockDim.x | 每个 block 中的线程数 |
gridDim.x | grid 中的 block 数 |
这些名称可对照 NVIDIA 的线程层级说明阅读。原课第 9 页左下角还出现了 gridIdx 和 threadDim,不要将它们当作这里可用的 CUDA C++ 内置变量;实现时使用表中这四个名字。
全局下标的计算式是:
int i = blockIdx.x * blockDim.x + threadIdx.x;
前一项计算这个 block 的起始位置,后一项加上块内偏移。例如,每块有 4 个线程,block 2 中的 thread 1 就负责:
i = 2 × 4 + 1 = 9
c[9] = a[9] + b[9] = 9 + 10 = 19
10 个元素,为什么会有 12 个逻辑线程#
每块有 4 个线程时,2 个 block 只能覆盖 8 个元素,需要向上取整为 3 个 block:
代码使用整数写法:
blocks = (n + threads_per_block - 1) // threads_per_block
因此,3 个 block 一共包含 12 个逻辑线程,但输入只有 10 个元素。
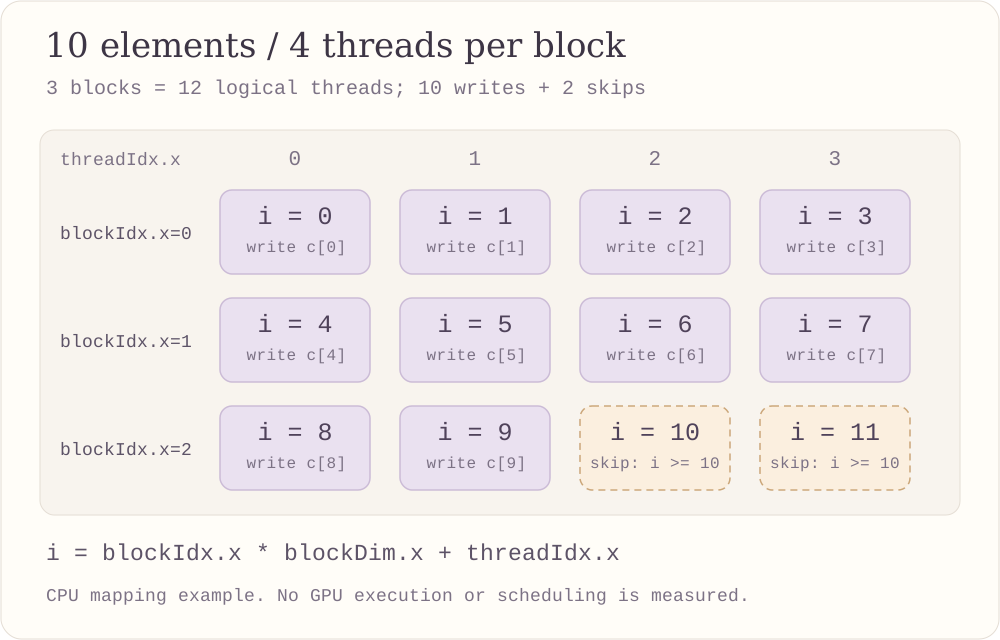
这张图按原始索引结果生成,可打开大图查看。下标 10、11 已经超出数组范围,需要由边界判断挡住:
if (i < n) {
    c[i] = a[i] + b[i];
}
每块 4 个线程是为了把关系看清楚,不是性能配置建议。逻辑线程数也不等于 GPU 同时拥有相同数量的物理执行单元。
CPU 演示实际检查了什么#
25_cuda_indexing.py 用两层普通循环枚举 block 和 thread:
for block_idx in range(blocks):
    for thread_idx in range(threads_per_block):
        i = block_idx * threads_per_block + thread_idx
        if i < n:
            output[i] = a[i] + b[i]
            visits[i] += 1
循环只是展示编号映射,不能据此推断 GPU 也会按这个顺序调度线程。
检查分成两部分:输出值与 PyTorch 的 a + b 完全一致;每个有效下标的访问计数都等于 1,既没有遗漏,也没有重复写入。输出数组先填为 NaN,这样漏写的元素也容易被发现。
默认例子得到:
N=10, threads/block=4, blocks=3
Output: [10.0, 11.0, 12.0, 13.0, 14.0,
         15.0, 16.0, 17.0, 18.0, 19.0]
原始 JSON 保存了每个逻辑线程的 block_idx、thread_idx、global_index 和是否写输出。六组边界案例均通过:
| 元素数 | 每块线程数 | Block 数 | 逻辑线程数 | 跳过的线程数 |
|---|---|---|---|---|
| 0 | 4 | 0 | 0 | 0 |
| 1 | 4 | 1 | 4 | 3 |
| 8 | 4 | 2 | 8 | 0 |
| 10 | 4 | 3 | 12 | 2 |
| 17 | 32 | 1 | 32 | 15 |
| 257 | 128 | 3 | 384 | 127 |
空输入直接得到空结果,不需要启动逻辑线程。对应 CUDA 实现也单独处理空输入,不把零大小 grid 当作启动示例。
另一份原始记录使用 17 个元素、每块 8 个线程。它得到 3 个 block、24 个逻辑线程,其中 7 个被边界判断跳过;最后一块只有下标 16 有效。整理时复跑了默认例子、这个配置和上表各项,结果及完整覆盖检查都通过。
CUDA 源码写到哪里了#
附件中的 cuda/25_vector_add.cu 使用相同的索引公式:
__global__ void vector_add(
    const float* a, const float* b, float* c, int n
) {
    const int i = blockIdx.x * blockDim.x + threadIdx.x;
    if (i < n) {
        c[i] = a[i] + b[i];
    }
}
完整文件还包含主机端的数据准备、设备内存分配、输入拷贝、kernel 启动、结果回传、逐元素核对和内存释放。启动之后写了两项检查:
check_cuda(cudaGetLastError(), "launch vector_add");
check_cuda(cudaDeviceSynchronize(), "execute vector_add");
第一项检查启动错误;第二项等待先前提交到设备的工作完成,并检查执行错误。普通 kernel 启动相对主机通常是异步的,“启动调用返回”与“计算已经完成”需要分开理解,具体行为以 NVIDIA 的异步执行说明为准。
首次记录时,这份 CUDA 文件尚未编译、尚未执行。 首次在 Mac 本机记录时的检查结果是:torch.cuda.is_available() 为 False,没有 nvcc 和 nvidia-smi,MPS 可用。MPS 可用不提供这份 CUDA C++ 程序的执行证据。
CPU 演示验证了索引计算和数值覆盖;它没有验证设备内存访问、实际线程调度、GPU 上的运行结果或速度。CUDA 目录中的运行说明保留了编译、执行与 Compute Sanitizer 检查命令,首次记录没有用预期结果代替实测输出;后续实际运行见下文续验。
和上一节的 batch size 有什么区别#
上一节的 batch size 决定一次送给模型多少个样本;这里的 block size 决定 kernel 的线程如何分组。它们属于不同层次,数值不需要相同。
一次 model(x) 里可能有多个框架操作。某个操作在设备上如何拆成 kernel,再如何组织线程,还取决于数据、后端和实现,不能把一行 Python 代码直接当成一个固定数量的 GPU kernel。
首次 CPU 练习只记录线程组织、全局下标和边界检查。矩阵分块与归约接在记录 07中,warp 级优化没有新增独立实验。
代码与原始记录#
历史 CPU ZIP 包含 25_cuda_indexing.py、两份原始 JSON、依赖与说明,以及明确标记为未验证的 CUDA 源码和运行说明。
运行 CPU 演示时,将复跑结果另存,保留随附的原始记录:
python3.11 -m venv .venv
.venv/bin/python -m pip install -r requirements.txt
.venv/bin/python 25_cuda_indexing.py \
  --output results/25_cuda_indexing-rerun.json

.venv/bin/python 25_cuda_indexing.py \
  --n 17 --threads 8 \
  --output results/25_indexing_17_8-rerun.json
原始记录保存在随附的实验结果 JSON 中,包含环境、脚本 SHA-256、完整映射和边界案例结果。
历史 CPU GitHub 代码 · 下载代码与结果 ZIP
后续补充:CUDA 编译、memcheck 与 Triton 实测#
学习聊天后来启用了一台获授权的单卡服务器,实际运行了相同的 cuda/25_vector_add.cu。设备名称报告为 NVIDIA GeForce RTX 4080 SUPER,compute capability 8.9,驱动 595.71.05,CUDA Toolkit 12.8。原生 runner 保存的源码 SHA-256 与本次公开文件一致。
nvcc -O2 -std=c++17 -lineinfo 编译成功。六组输入中的空向量明确记录 no launch required;其余五组均为 PASS,包括 N=10 的尾部越界线程和 N=257 的多 block 配置。随后执行:
compute-sanitizer --tool memcheck --error-exitcode 1 ./build/cuda/25_vector_add
报告为 ERROR SUMMARY: 0 errors,退出码 0。编译器仍给出了旧架构离线编译支持将移除的提示;编译成功不等于完全没有 warning。Sanitizer 的结论限于本次输入与检查范围,原生向量程序没有计时。
38 号脚本另用 Triton 写了相同的向量加法。输入为 float32,长度取 0、1、17、257、1048576,每种长度分别使用 BLOCK=256/1024,与 PyTorch a+b 的逐元素精确比较均通过。尾部仍靠 mask 保护:
offsets = tl.program_id(0) * BLOCK + tl.arange(0, BLOCK)
a = tl.load(A + offsets, offsets < N, other=0)
b = tl.load(B + offsets, offsets < N, other=0)
tl.store(C + offsets, a + b, offsets < N)
这里的 BLOCK 表示一个 Triton program 处理的元素数,不能直接当作 CUDA C++ 的 blockDim.x。N=1048576 时,两种 BLOCK 的 event 中位数约为 0.05315/0.05263 ms;两者接近,单次记录不能给出通用配置建议。
GPU Python 环境为 Python 3.12.3、PyTorch 2.7.0+cu128、Triton 3.3.0,与前文 Mac CPU 环境分开。计时先 warmup 5 次,再收集 15 个样本,每个样本平均 10 次调用。它是 CUDA stream 上的提交区间,可能包含 Python 提交或分配造成的 GPU 空闲;排除初次 JIT 和主机/设备传输,不能解释为孤立 kernel 耗时或端到端服务延迟。
发布整理时核对了原始输出、退出码、源码哈希和计时样本,没有在 Mac 上复跑 GPU。最新共享 ZIP 包含原生源码、runner、38 号脚本、两份原始报告及独立 GPU 依赖说明;前文 CPU ZIP 和历史代码链接继续保留。
python3.12 -m venv .venv-gpu
.venv-gpu/bin/python -m pip install -r requirements-gpu.txt
.venv-gpu/bin/python cuda/run_native_checks.py --output results/cuda-native-rerun.json
.venv-gpu/bin/python 38_gpu_kernels.py --output results/38-gpu-rerun.json
原生 runner 还需要 NVIDIA 驱动、nvcc 和 Compute Sanitizer。CUDA 不可用会报错,不记为验证通过。
评论
评论由 GitHub Discussions 驱动,使用 GitHub 账号登录即可留言。