
个人课程项目中的 CPU 实验记录,延续记录 11 的分页 KV 实现。已完成 210 组配置与 1470 次计时,输出均通过连续存储参考对照;本篇不代表正式作业提交、整门课程或项目全部交付完成。
同样是共享 31 个 token,块长 4 时只占 29 KiB 活跃 K/V 槽位,块长 32 时却占 112 KiB。页变大后,共享前缀没有变短,但能完整保留给多个请求共用的页消失了。这次把这个边界与实际分配容量、复制和 CPU 耗时放在一起看。
源码和原始报告保存在项目实验快照中。发布整理时从独立副本重跑完整扫描,210 行的输出误差、槽位、页数与复制计数均复现,复跑时间另存,没有覆盖原始测量。
固定输入,比较四条存储路径#
实验使用预先生成的单头 K/V/Q,每组 8 个请求。K、V 各宽 16,float64,因此一个成对的 K/V token 槽位为:
同一工作负载的四种策略使用完全相同的张量和 Attention 参考:
| 策略 | 保存方式 | 增长或分支时的处理 |
|---|---|---|
| static | 每个请求按该组最长最终长度预留连续张量 | 写入已有槽位 |
| dynamic | 每个请求只保留当前连续 K/V | 每步 torch.cat,复制已有前缀 |
| paged | 每个请求拥有独立页 | 页表寻址,按需占用池内页 |
| shared | 复用 33 号脚本的引用计数与前缀 fork | 完整页共用,部分尾页写时复制 |
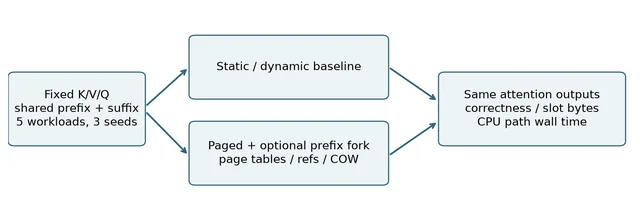
五类输入的共同前缀长度分别为 0、3、31、32、63,种子为 41、42、43。每类的 prompt 基准长度加 [0,1,3,7],decode 长度为 [1,2,4,8],在 8 个请求中重复两次。共同前缀为 0 的一组使用 prompt 基准 31,其余组的基准等于共同前缀长度。
块长 B 扫描 2、4、8、16、32、64。两个连续基线加上两种分页策略各六个块长,一共 14 种配置;乘以 5 类输入、3 个种子,得到 210 行。每行先执行一次预热/正确性检查,再测量 7 次,共 1470 次计时。
这里没有 tokenizer、真实语言模型、在线到达、准入调度或 radix tree。共享前缀由输入直接给定;所有请求一直保留到结束,不能把本实验当作真实服务吞吐测试。
先把活跃槽位和池容量分开#
原始数据有三个容易混淆的字段:
| 字段 | 实际含义 |
|---|---|
active_slot_bytes | 当前保留的 K/V 槽位容量;分页时按仍在使用的整页计,包含尾部空位 |
pool_tensor_bytes | 底层池张量实际预分配的 K/V 数据量 |
copied_old_token_slots | 动态拼接或 COW 搬动的旧 K/V 成对 token 槽位数 |
第三项不包含 prompt 初次写入、新 token 写入、gather 物化或 Attention 读写流量,不能换算成所有内存流量。dynamic 的保留量也不包含 cat 新旧张量同时存在的瞬时内存。
共同前缀为 31 时,三个种子的存储与复制计数相同:
| 策略 | 活跃槽位(KiB) | 池/保留张量(KiB) | 搬动的旧 token 槽位 |
|---|---|---|---|
| static | 92 | 92 | 0 |
| dynamic | 75 | 75 | 1140 |
| 独立分页 B=4 | 78 | 78 | 0 |
| 共享分页 B=4 | 29 | 78 | 21 |
| 共享分页 B=32 | 112 | 112 | 217 |
共享 B=4 的活跃槽位降到了 29 KiB,但池仍有 78 KiB。这份实现预先按独立请求的容量建立池,共享和独立路径用相同容量;少占活跃页后,没有重新缩小底层张量。
因此,29 KiB 不能写成进程只分配了 29 KiB,更不能直接声称显存峰值下降了同样比例。实验没有测量 RSS、分配器、Python 元数据或 gather/Attention 临时张量的峰值。
31 与 32:完整页共享的边界#
设请求数为 R、共同前缀长度为 L、页长为 B。在本次所有分支随后都增长、请求均保留的配置中,独立分页比共享分页多出的物理页数是:
前缀若留下不完整尾页,其他 R−1 个分支写入时需各复制这段尾部,旧 token 槽位复制数为:
R=8、L=31、B=4 时,有 7 个完整前缀页可共享,省下 49 个页,即 49×4×256=49 KiB;独立分页的 78 KiB 减去它,正好是 29 KiB。尾部 3 个 token 在其他七个分支中各复制一次,共 21 个槽位。
L=31、B=32 时,没有完整前缀页。分支写入后,原来那一页也因 COW 分开,最终与独立分页同为 112 KiB,复制数为 7×31=217。
把共同前缀移到 32,B=32 就能保留一整页共享,复制数变为 0。该组共享 B=32 的活跃槽位为 72 KiB,独立分页为 128 KiB;共享 B=4 则为 24 KiB,池容量仍为 80 KiB。对齐边界可以恢复共享,但更大的尾部空位仍可能使大页占用更多。
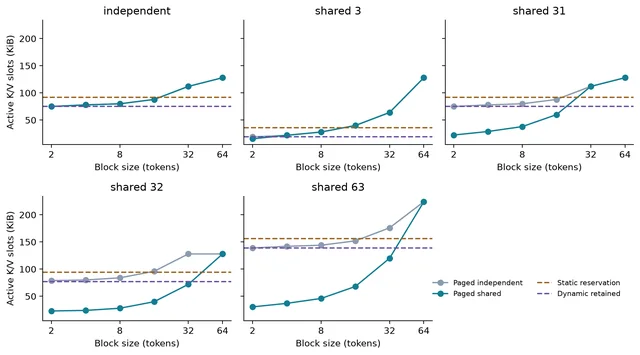
查看存储图原图。图中数值来自原始 JSON;发布版仅调整面板、刻度和图例排版。
这两条公式针对当前 fork/COW 和工作负载。请求释放、分支不再增长、部分页共享策略变化时,需要重新分析,不能当作所有缓存实现的固定规律。
CPU 分页路径更慢,这个结果也要留下#
原始环境是 macOS arm64、Python 3.11.15、PyTorch 2.14.1,CPU 线程数固定为 1。每行 7 次测量先取中位数,下表再取三个种子中位数的中位数,单位毫秒:
| 策略 | 共同前缀 31 | 共同前缀 32 |
|---|---|---|
| static | 0.445750 | 0.492750 |
| dynamic | 0.350792 | 0.369875 |
| 独立分页 B=4 | 2.255917 | 2.432292 |
| 共享分页 B=4 | 1.103708 | 1.138666 |
| 共享分页 B=32 | 1.048958 | 1.116625 |
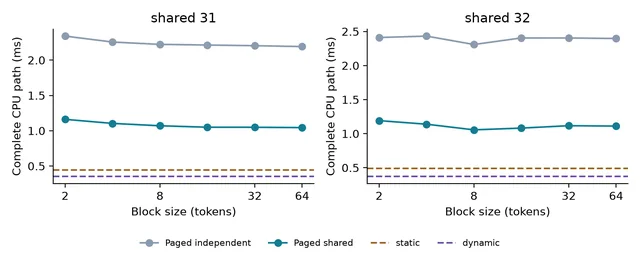
计时包括分配、prompt 插入、fork、append、gather、Attention、输出 stack 与指标统计;输入生成和正确性断言在区间外。每轮随机打乱策略顺序,全部策略都与相同连续参考检查,210 行最大绝对误差均为 0。
当前分页实现使用 Python 页表与引用计数,Attention 前还会 gather 出连续 K/V。共享减少了重复 prompt 插入,但两条分页路径仍慢于连续存储基线。dynamic 在这些小规模输入下也比 static 快;本次数据不能证明“预分配一定更快”。
这些时间描述当前 CPU 完整路径。它们没有分离页表、复制、gather 各自的耗时,也没有实现 GPU 上直接读取分页 K/V 的 Attention kernel,因此不能据此评价 vLLM/PagedAttention 的真实 GPU 性能。不同机器和运行状态会改变计时,复验只要求结构、数值和计数一致,不要求毫秒数完全重现。
复现、代码版本与课程位置#
ZIP 包含 33_paged_kv_cache.py、项目执行/分析脚本、原始 210 行 JSON、汇总、三张图、两项项目测试及依赖说明。GPU 实验另见记录 06–08 的续篇;本项目原始 JSON 中的历史 gpu_status 记录当时 CPU 项目安排。
python3.11 -m venv .venv
.venv/bin/python -m pip install -r course/project/requirements.txt
.venv/bin/python course/project/run_experiments.py \
  --output results/project-rerun.json
.venv/bin/python -m unittest discover -s tests -v
.venv/bin/python course/project/analyze_results.py
分析脚本默认读取随附的 results/project_kv_granularity.json,生成原始测量的图表,不会自动切到上面另存的复跑文件。测试检查输出等价、不同页边界、完整页共享和部分页 COW 计数;ZIP 的 2 项项目测试及完整发布仓库的 54 项现有测试均通过。
这部分对应原课课程项目安排下的个人实验探索,机制背景可对照 PagedAttention 论文。已经复现的代码实验与下方报告/展示分别归档;材料生成、本人的掌握程度和正式提交各有独立验收边界。
项目报告与中文展示#
同一实验的文档和展示现已生成,补在本篇。英文报告沿用上面的 CPU 原始数据,展开四种存储路径、完整页共享与部分页 COW 的公式、实验设计和限制;没有加入新的 GPU KV 性能结论。一页项目规格在原型之后整理,不能视作此前已经提交的提案。
- 一页项目规格 PDF。
- 英文实验报告 PDF:正文 5 页 + 参考文献 1 页,使用 MLSys 2025 模板。
- 播放或下载中文展示 MP4:9 分 0.14 秒,1280×720、12 章。
- 阅读或下载中文讲稿:Markdown 格式,与视频制作脚本逐章一致。
- 下载文档与制作源码 ZIP:约 694 KiB,含两份 PDF、LaTeX/模板、讲稿、视频脚本、原始数据和项目测试;MP4 单独下载。
报告、代码与展示由 Codex 辅助制作,视频使用 macOS Tingting 合成语音,不是学习者本人录制。视频依次讲解缓存增长、相关工作、页表与引用计数、210 组配置、正确性、共享/复制/池容量/时间结果,以及适用范围。报告采用的模板附有自学声明,不代表会议接收或正式课程提交。
归档前检查了一页规格和六页报告的版式、公式与引用,核对了 12 章视频画面、讲稿和制作脚本,并完整解码 MP4。实验执行代码、原始 JSON 和数值汇总与前面的实验发布一致;这次没有重新计时。文件检查不能代替本人理解、课堂展示或课程验收。
文档快照保留生成 PDF/视频时的图表与目录结构,和文章图表可能有排版差别。复做 PDF 需要 Tectonic;复做视频还需要 macOS 的 say、Tingting 语音和指定中文字体,具体命令见快照说明。
评论
评论由 GitHub Discussions 驱动,使用 GitHub 账号登录即可留言。