
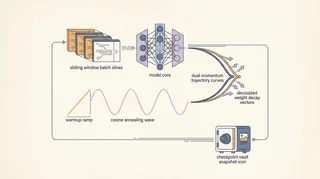
Stanford CS336 学习记录 08:数值稳定交叉熵、AdamW、余弦调度与完整训练闭环
用 LogSumExp 消去交叉熵中的指数溢出,手写解耦权重衰减的 AdamW 优化器、全局 L2 梯度裁剪、Warmup 余弦退火调度、memmap 数据采样、Checkpoint 序列化与 Top-p 解码,完成 CS336 Assignment 1 全部 48 项测试。
FOLLOW THIS THREAD
Notes on this topic
16 篇公开笔记,沿着这个标签慢慢读。
用 LogSumExp 消去交叉熵中的指数溢出,手写解耦权重衰减的 AdamW 优化器、全局 L2 梯度裁剪、Warmup 余弦退火调度、memmap 数据采样、Checkpoint 序列化与 Top-p 解码,完成 CS336 Assignment 1 全部 48 项测试。
将 RMSNorm、带 RoPE 的因果多头自注意力和 SwiGLU 组装成 Pre-Norm Transformer Block,搭建完整 TransformerLM,并核算 GPT-2 XL 的参数量与前向 FLOPs。
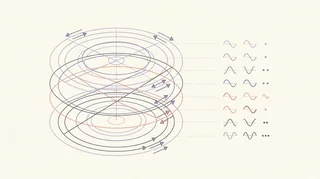
从二维平面正交旋转推导 RoPE 的奇偶特征配对公式,理解为什么内积只依赖相对位置差 (i - j),并用 register_buffer 预计算 cos/sin 缓存接入因果多头自注意力。
沿着 (2, 5, 64) 的输入追踪 QKV 投影、reshape、transpose、共享因果 mask 和合头,理解每个头仍处理完整序列,以及最后为什么还需要输出 Linear。
从减去最大值为何不改变 Softmax 开始,理清函数与有参数层的区别,再沿着 Q、K、V 的形状理解缩放点积注意力,以及 mask 为什么必须填负无穷。
用一个 token 向量理解均方根归一化,拆开 dim=-1 与 keepdim=True 的作用,再沿着两条分支读懂 SiLU、逐元素乘法和 SwiGLU。
从 PyTorch 类、参数与 forward 的关系开始,理解 Linear 为什么保存两行三列的权重、计算时为什么要转置,再区分 Embedding 查表与线性变换。
用 CPU 实验验证 BatchNorm 折叠、RMSNorm 重排与非线性反例,测量分块候选,并运行 TorchInductor,分别记录首调用与预热后的时间。
在 CPU 上对照完整 Attention、在线 Softmax 分块实现与 PyTorch SDPA,检查因果掩码、浮点误差和分数块大小,理解 FlashAttention 的一部分算法基础。
对照 ML Systems 基础,用 Profiler 拆开两层网络的执行过程,再固定 1000 个样本扫描 batch size,观察算子调用次数、尾批和 CPU 耗时。
把 nn.Linear 对应到矩阵乘法,弄清多个输出怎样计算,再逐层拆开一个绝对值网络,比较手动设置参数与训练得到的结果。
用 DataLoader 分批训练平方函数,保存并加载模型参数,再比较 1000 个样本与 1 个样本的推理耗时,最后把批量计算对应到矩阵乘法。
从带偏置的线性回归开始,弄清 nn.Linear 和 nn.Module 的分工,再用平方函数观察线性模型的限制、ReLU 的作用和测试点的选择。
从自动求导和手动梯度下降开始,比较学习率,再用 SGD 训练线性回归。记录 w * 4 写错后停在 1.25 的原因和修正结果。
从 MuJoCo 抓取搬运闭环出发,记录 22,100 个评测回合。动作平滑在自建任务的 50 ms 延迟下有效,换到 Panda Lift 却没有支持同样的收益。
从零实现 PyTorch CUDA 扩展,拆解 RMSNorm 的访存瓶颈、warp 归约、向量化加载、算子融合与冷热缓存 benchmark。