
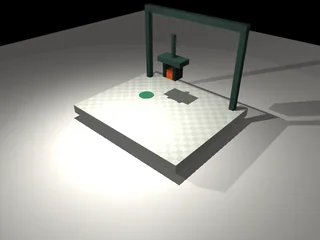
Pickplace Lab 从一个简单任务开始:让夹爪抓起方块,搬到指定位置,放下,再退开。先把仿真、示范采集、训练和闭环评测接起来,随后再问:干净条件下成功的策略,换一种执行条件,还能不能完成任务?
最值得讨论的结果出现在指令延迟实验里。固定模型权重,只给平移动作加一个简单的指数平滑,自建任务在 50 ms 延迟下的成功率从 56.0% 提高到 86.6%。但换到 Panda Lift,采用同一平滑系数,成功率从 67.2% 变成了 60.8%。
前一个结果可以解释改进,后一个结果限制了结论。两者都保留在项目里。
本文对应 项目 v0.1.0 阶段性实验复盘。开发、实验执行和材料整理使用了 AI 辅助;数值来自保存的本地运行记录。项目已经公开,但尚无独立第三方复现或外部采用的证据。
先把一次抓取定义清楚#
教学环境用 MuJoCo 模拟接触物理。机器人是三轴笛卡尔夹爪,动作包含 XYZ 方向的位置增量和夹爪开合。输入直接使用环境状态,没有相机图像和语言指令。
抓取依靠接触与摩擦,执行过程中没有把方块焊接到夹爪上,也没有直接移动物体位置来制造成功。
封面来自这个任务的实际仿真渲染。后文的 Panda 是另一个七关节机械臂仿真任务,两者都不是真机实验。
任务也不以“方块被抬起来”结束。判定成功需要完成抬升、搬运、稳定放置、松爪和退开,并连续保持 8 个控制步。只把方块推到目标附近,或者夹着方块停在目标上方,都不算成功。
训练部分从行为克隆开始:用脚本专家采集示范,让策略学习状态到动作的映射。初版保留了 32 条和 256 条示范的对照,也做了 DAgger 纠正学习。DAgger 额外用了专家标注,所以不能把它写成同等标注预算下的公平胜出。
这一步解决的是工程闭环。数据能不能读、权重能不能保存和加载、动作是否真的进入仿真、失败能不能复查,都需要有具体产物。
干净条件下 100%,为什么还要继续测#
后续研究把坐标表示和观测噪声增强拆开,做了 5 个模型、5 个训练与数据子集种子、6 种部署条件,每组 100 个场景,共 15,000 个闭环评测回合。
测试条件包括位置分布变化、传感噪声、50 ms 指令延迟、动力学变化,以及组合扰动。协议、主比较和测试场景在这一阶段训练与评测前固定。
原本想验证的“相对坐标 + 噪声增强”没有改善预先指定的平均扰动指标。它比原始 BC32 低 7.72 个百分点,探索性配对 bootstrap 95% 区间为 -12.60, -2.68 个百分点。
另一条观察更直接:BC256 在干净条件下,五次训练的测试成功率都是 100%;加入 50 ms 指令延迟后,平均成功率降到 49.6%,跨训练运行标准差为 17.8 个百分点。
这里的延迟是在仿真控制链里排队执行动作。环境控制频率为 20 Hz,一个控制周期就是 50 ms。它不是测量 Python 推理耗时,也不是一次真实网络延迟测试。
“更多示范导致时延表现变差”并不是这些数字已经证明的因果关系。它们能支持的观察是:这组干净条件下表现很好的模型,对这里定义的指令延迟很敏感。
五个种子还同时改变了训练子集和优化随机性,不能把不确定性只归到其中一个来源。完整结果保存在研究 v1 报告中。
失败回放提供了什么线索#
一个配对样例使用相同权重和初始场景:无延迟时,61 个控制步完成任务;加入 50 ms 延迟后,220 步超时。
查看轨迹,延迟版本最后 40 步请求的 Z 方向动作每步变号,夹爪高度持续上下振荡。方块已经接近目标 XY,但仍被夹着,没有完成放下、松爪和退开。
这条回放说明了选定样例怎样失败,却不足以证明所有失败都来自同一个机制。对应的诊断记录与结论边界也保留了这一限制。
接下来的实验因此收窄成一个具体问题:保持模型不变,改变动作执行方式,能否缓解这一类延迟条件下的失败?
固定权重,只改动作执行#
后续实验另行固定协议,使用新场景种子,共 4,500 个回合。五个 BC256 权重保持不变,比较原始执行、XYZ 增益减半和 EMA 指数平滑。平滑系数固定为 0.5,没有根据测试结果再搜索系数。
EMA 只作用于平移动作:
filtered_xyz = 0.5 * requested_xyz + 0.5 * previous_filtered_xyz
夹爪开合指令不变,每个回合开始时把滤波状态清零。不同执行方式使用相同场景种子,成功条件和最大回合长度也不变。
| 执行方式 | 干净条件 | 50 ms 延迟 | 100 ms 延迟 |
|---|---|---|---|
| 原始执行 | 100.0% | 56.0% | 52.4% |
| XYZ 增益减半 | 36.6% | 84.0% | 88.6% |
| EMA,系数 0.5 | 99.6% | 86.6% | 40.6% |
50 ms 的预先指定主比较提升 30.6 个百分点,探索性配对 bootstrap 95% 区间为 +17.0, +42.6 个百分点。
但把表格读完整,就不能把它概括成“加平滑就更稳”。EMA 在 100 ms 下反而退化;增益减半虽然改善了两个延迟条件,却明显伤害干净条件的成功率。
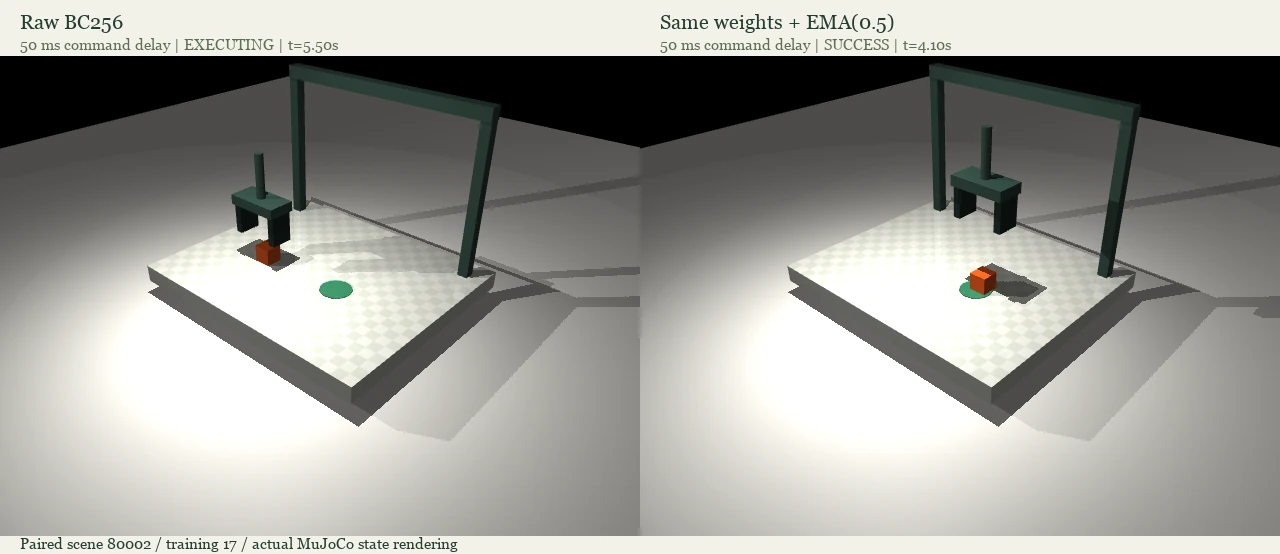
自动选出的一个 50 ms 改善样例:训练种子 17,场景种子 80002。图用于解释单条轨迹,整体结论以全部回合统计为准。
前面研究里的 49.6% 和这里的 56.0% 来自不同阶段的场景集合。后续干预的正确对照是 56.0% 对 86.6%,不能把 49.6% 拿来拼出更大的提升。
另外,EMA 本身是已有的标准滤波方法。这部分工作是固定权重的工程干预实验,不是新算法,也不是安全控制器。滤波会改变动作和反馈分布,不能据此锁定唯一的失败原因。逐条件结果、协议和退化样例见后续实验报告。
换成 Panda 之后,结论没有直接迁移#
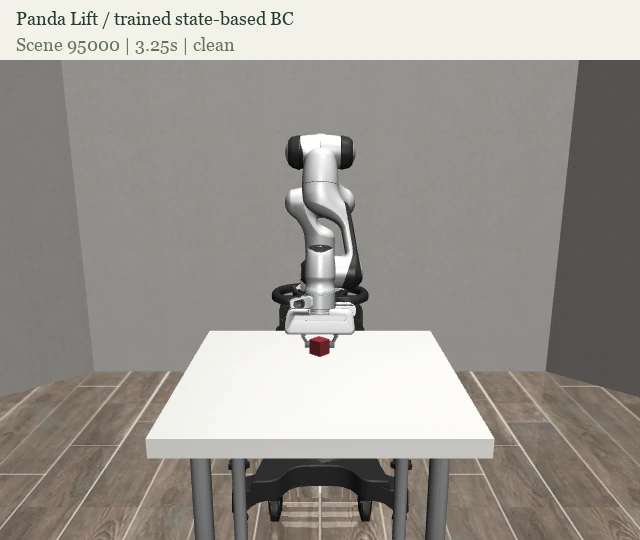
自建夹爪的结果需要在另一个任务上检验。这里选择 robosuite 的 Panda Lift:七关节 Panda 机械臂抓起方块,使用该任务自己的 128 条训练示范、16 条验证示范,另行训练五个状态策略。
这一阶段没有复用自建任务的数据或权重。它完成了 1,500 个学习策略回合和 100 个基线回合,使用官方抬升成功指标,并另外记录连续保持 8 步的严格指标。
| 执行条件 | 原始 BC 官方成功率 | EMA 官方成功率 |
|---|---|---|
| 干净条件 | 100.0% | 77.2% |
| 50 ms 延迟 | 67.2% | 60.8% |
| 100 ms 延迟 | 70.8% | 77.6% |
50 ms 主比较的差值为 -6.4 个百分点,探索性配对区间为 -23.2, +10.4 个百分点。区间跨过零,这次复验没有支持迁移收益,也不足以据此断言总体上一定有害。
不能因为 100 ms 那一行更好,就事后换一个主指标宣布假设成功。干净条件下的损失同样需要解释。
Panda 这里固定训练数据,只改变优化与打乱种子;它和前面同时改变示范子集的研究,所刻画的不确定性并不相同。任务 horizon 为 200 个控制步,使用固定旋转动作和提前终止规则,不等同于标准榜单协议。这是本地标准任务复验,不是外部研究者做出的独立验证。细节见 Panda 报告。
仓库留下了哪些证据#
整个项目有 22,100 个正式评测回合:初版对照 1,000 个、研究 v1 15,000 个、后续干预 4,500 个、Panda 1,600 个。这个数字是不同协议的工作量总和,不能当成同分布独立样本池。
除了 33 个模型权重,仓库还包含示范数据、逐回合结果、冻结协议和源代码快照。研究 v1 的 271 条选定重放、Panda 的 55 条选定重放,以及后续干预的改善和退化配对,都保留了复查入口。选定轨迹复跑过,不等于全部 22,100 回合都逐条重新执行过。
发布前,两套隔离环境的测试共 47 项通过:原项目与滤波扩展 42 项,Panda 5 项。发布包也解压到新目录检查过来源解析、数据与权重哈希。但这些检查复用了本机已有依赖,不是全新安装测试。GitHub Actions 只验证文件完整性,不重跑仿真。
项目暂时没有图像策略、VLA、真机结果、安全认证、榜单成绩或已被采纳的上游贡献。公开仓库提供了检查入口,外部可信度仍需要真实的独立复现和反馈。
怎样自己看一遍#
只看研究页面,不需要先装 PyTorch 或 MuJoCo:
git clone --branch v0.1.0 --depth 1 \
  https://github.com/liangqianxing/embodied-pickplace-lab.git
cd embodied-pickplace-lab
python3 scripts/verify_manifest.py
python3 -m http.server 8766 --bind 127.0.0.1 \
  --directory artifacts/study/v1
打开 http://127.0.0.1:8766,可以查看完整结果、延迟轨迹和配对动画。
要运行新的模型推理,再创建隔离环境。原始验证环境是 Python 3.11、macOS Apple Silicon;其他系统需要单独确认依赖和数值复现情况。
python3.11 -m venv .venv
.venv/bin/python -m pip install -r requirements-lock.txt
.venv/bin/python -m pip install -e . --no-deps
.venv/bin/pickplace serve --port 8765
这个页面可以选策略、位置分布和种子,重新运行仿真。新试跑不会写进冻结研究的结果表。Panda 使用另一套依赖,安装方式见独立环境说明,不要和主环境混装。
如果想继续这个项目,我更愿意先回答两件事:不同任务对平滑的响应为什么不同;另一台机器能否按说明得到一致的记录检查和选定回放。它们比再加一段成功视频更能检验现有结论。
欢迎通过复现反馈入口记录成功或失败。附上版本、环境和命令即可;提交日志前,记得删掉个人路径与凭据。
评论
评论由 GitHub Discussions 驱动,使用 GitHub 账号登录即可留言。