
生成式视觉模型正在经历从“生成高保真像素(Pixel Synthesis)”向“可控结构化生成(Controllable & Editable Generation)”的演进。在这一进程中,我作为第一作者或核心贡献者参与了两项分别处于底层扩散采样动力学与上层多模态可编辑系统的研究工作:
- In-situ Autoguidance(Eliciting Self-Correction in Diffusion Models,ICML 2025 Workshop 第一作者,arXiv:2510.17136):研究如何在不引入任何额外辅助网络或重训练开销的前提下,仅通过单模型推理期局部随机微扰(Stochastic Dropout Perturbation)激发扩散模型的原位自校正引导能力;
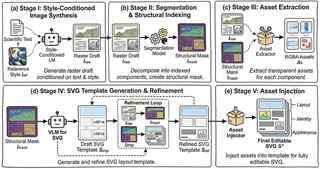
- AutoFigure-Edit(Generating Editable Scientific Illustrations via Reference-Guided Styling,ACL 2026 System Demonstrations,Paper / Code):研究如何打破纯像素生成模型“好看但完全不可编辑”的痛点,通过“风格生成—结构索引—素材提取—SVG 模板精修—矢量注入”五阶段流水线,从论文文本直接生成原生可编辑的科研架构图(FigureBench 人工盲评胜率 83.0%)。
本文将这两项工作放在“生成质量控制与结构化可编辑性”的统一视角下,拆解其核心数学原理与系统实现。
第一部分:In-situ Autoguidance —— 单模型如何实现免辅助网络的自校正引导?#
1. 标准 CFG 与 Karras Autoguidance 的显存与训练困境#
在扩散模型采样中,Classifier-Free Guidance(CFG)通过拉大条件预测 与无条件预测 的差距来提高文本遵循度,但过度提高引导系数会导致色彩过饱和与分布失真,且无法用于无条件生成。
Karras 等人提出的 Autoguidance 指出:引导的本质是“用一个主模型减去一个犯同类错误但程度更深的退化模型(Bad Model )”,从而构造指向高密度数据流形的修正向量。然而,原始 Autoguidance 要求专门训练并同时在显存中常驻一个欠训练或缩减容量的辅助网络 :
- 显存开销翻倍:推理时需要同时加载主模型 与辅助模型 ,参数显存占用增加近 ;
- 超参搜索昂贵:如何为任意已开源的预训练扩散模型匹配恰当退化程度的 ?一旦主模型没有公开发布早期训练 Checkpoint,原始 Autoguidance 便无法直接应用。
2. 核心方法:基于推理期受控微扰的原位自引导(In-situ Self-Correction)#
在 In-situ Autoguidance(arXiv:2510.17136)中,我们提出了一个关键洞察:无需额外部署任何退化网络,同一个预训练扩散模型在“确定性完整前向”与“推理期局部随机丢弃微扰(Stochastic Dropout Perturbation)”之间的预测差分,天然构成了沿数据流形切向的高质量自校正梯度。
具体而言,给定预训练去噪网络 及其内部特定深层模块集合 ,我们在同一个模型权重上构造两次前向传播:
- 主分支(Clean Deterministic Pass):关闭所有随机丢弃,执行完整确定性推理,得到基准去噪估计 ;
- 原位退化分支(Perturbed Pass):在同一网络 的受控子层激活推理期随机微扰掩码 ,得到轻度退化的去噪估计 。
由此,原位自引导采样更新公式定义为:
其中 为自引导强度系数, 为局部微扰率。
import torch
import torch.nn as nn

@torch.no_grad()
def in_situ_autoguidance_step(
    net: nn.Module,
    x_t: torch.Tensor,
    sigma_t: torch.Tensor,
    cond: torch.Tensor,
    guidance_weight: float = 1.5,
    perturb_rate: float = 0.1,
    target_blocks: tuple[int, ...] = (12, 13, 14, 15),
) -> torch.Tensor:
    """单模型原位自校正引导:零额外模型权重,构造确定性分支与受控微扰分支的差分引导向量。"""
    # 1. 确定性主分支前向 (Clean Pass)
    net.eval()
    d_clean = net(x_t, sigma_t, cond)

    # 2. 仅在指定中深层 Block 临时开启推理期 Dropout 微扰 (Perturbed Pass)
    hooks = []
    for idx, block in enumerate(net.blocks):
        if idx in target_blocks:
            hooks.append(
                block.register_forward_hook(
                    lambda m, inp, out: nn.functional.dropout(out, p=perturb_rate, training=True)
                )
            )
    try:
        d_perturbed = net(x_t, sigma_t, cond)
    finally:
        for h in hooks:
            h.remove()

    # 3. 沿 (d_clean - d_perturbed) 方向执行流形自校正外推
    return d_clean + guidance_weight * (d_clean - d_perturbed)
3. 实验验证与系统优势#
我们在 EDM2-S / ImageNet-512(50,000 张生成样本标准评测)上系统验证了 In-situ Autoguidance 的有效性:
| 引导方案 | 额外辅助模型参数 | 是否需要重训练 / 早期权重 | 显存增量 | 核心生成表现(ImageNet-512) |
|---|---|---|---|---|
| 标准无引导 / 朴素 CFG | 0 | 否 | 0% | 高引导系数下易出现纹理过饱和与高频伪影 |
| 原始 Autoguidance | (需常驻 ) | 需专门训练退化小模型 | FID 显著改善,但部署成本翻倍 | |
| In-situ Autoguidance(本文) | 0 | 完全免训练(Plug-and-Play) | 在不增加任何模型权重的条件下显著降低 FID,消除局部结构畸变 |
第二部分:AutoFigure-Edit —— 如何让 AI 生成的科研插图原生可编辑?#
如果说 In-situ Autoguidance 解决了连续像素流形上的精细自校正,那么在科研绘图(Scientific Illustration)场景中,研究者面临的是另一个维度的挑战:即便最新的文生图模型能画出视觉精美的架构图,输出的位图(PNG/JPEG)一旦出现拼写瑕疵、箭头错位或审稿人要求修改模块名称,作者根本无法在 Illustrator 或 Figma 中直接编辑,只能推倒重画。
在被 ACL 2026 System Demonstrations 录用的 AutoFigure-Edit(aclanthology.org/2026.acl-demo.6)中,我们设计了一套参考风格引导的五阶段视觉-符号混合流水线,将“视觉审美生成”与“精确矢量拓扑编译”彻底解耦:
1. 五阶段协同流水线拆解#
[输入:论文方法章节 LaTeX/PDF + 参考风格图]
   │
   ├─► Stage 1: 参考引导风格生成 (Reference-Guided Style Synthesis)
   │     利用多模态模型融合论文逻辑结构与参考图的配色/线框视觉语言,生成高审美视觉参考底图
   │
   ├─► Stage 2: 版面结构索引 (Structural Layout Indexing)
   │     结合 MinerU v4 与多模态框检测,定位所有容器框、连接箭头、文本标签与子图标的精确包围盒 (BBox)
   │
   ├─► Stage 3: 独立视觉素材提取与去背 (Asset Extraction & Matting)
   │     将非几何类的复杂小图标(如服务器、分子结构、小机器人图标)分割抠图并透明化处理
   │
   ├─► Stage 4: SVG 矢量骨架生成与多轮视觉自校正 (SVG Template Refinement)
   │     将容器、分组框、正交/贝塞尔箭头与可选中文本编译为标准 SVG DOM 树,并通过 VLM 渲染比对修正坐标偏移
   │
   └─► Stage 5: 素材精确注入与图层组装 (Vector & Asset Injection)
         将抠取的高清局部素材按锚点坐标嵌入 SVG 骨架,输出图层分明、文字可改、框线可拖拽的原生 .svg 文件
2. FigureBench 200 题人工盲评与结构化指标#
为了客观评测生成插图的学术可用性,我们在包含 200 个真实科研绘图任务的 FigureBench 基准上开展了双盲人工评估(对比直接文生图与纯代码生成基线):
- 整体人工盲评胜率(Overall Win Rate):达到 83.0%,显著优于纯代码直接输出 SVG(缺乏审美排版与复杂视觉图标)与纯像素生成(文字乱码且不可二次编辑);
- 原生可编辑性:输出的 SVG 文件中,所有模块标题、数学上下标、容器圆角矩形与连接线均为独立 DOM 节点,研究者可在几秒钟内直接修改字体、颜色与模块布局。
三、总结:从连续流形引导到离散符号-视觉协同#
回顾这两项工作,它们分别代表了提升生成式 AI 可控性的两条核心路径:
- 在模型内部挖掘原位对比信号:In-situ Autoguidance 证明了预训练扩散模型自身即包含“完整表征”与“微扰退化表征”的层次差异,善用推理期局部微扰即可零显存增量换取显著的自校正增益;
- 用多阶段视觉-符号流水线弥合“好看”与“可用”的鸿沟:AutoFigure-Edit 证明了在严谨的科研与工业生产流中,让多模态生成模型负责“审美与构图先验”,让版面解析与矢量编译器负责“几何拓扑与可编辑文本”,是通往高可用 Agentic 生产力工具的最佳范式。
评论
评论由 GitHub Discussions 驱动,使用 GitHub 账号登录即可留言。