
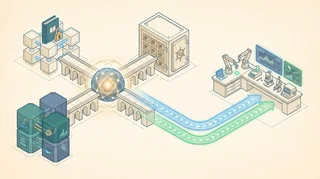
DeepScientist(deepscientist.cc)是我们在西湖大学自然语言处理实验室研发的自主科学发现与科研管理平台,目前累计服务 7,000+ 科研用户。与单轮对话或纯文本文献问答工具不同,科研智能体需要在数小时乃至数天的跨度内围绕一个研究课题(Quest)持续执行文献检索、假设生成、实验代码编写、容器沙箱运行、图表生成与论文撰写。
本文系统梳理 DeepScientist 的整体系统架构、超 100K Token 长上下文 Agent 运行时、MCP(Model Context Protocol)工具协议栈、Docker SDK 容器沙箱编排以及高并发双流(SSE + WebSocket)后端基础设施设计。
一、整体拓扑:控制面、Agent 运行时与隔离沙箱面#
为了让智能体既能安全执行任意 Python / Bash 实验脚本,又能与前端富文本编辑器、代码工作台和远程桌面实时同步状态,我们将系统划分为三层解耦架构:
┌────────────────────────────────────────────────────────────────────────────┐
│                        Web 工作台 (Next.js 15 / React 18)                  │
│   Tiptap + Yjs CRDT 协同文档 │ Monaco 代码工作台 │ XTerm.js 终端 │ noVNC   │
└───────────────┬──────────────────────────────────────────┬─────────────────┘
                │ HTTP + SSE (100K+ 流式推理/工具事件)       │ WebSocket (终端/协同)
┌───────────────▼──────────────────────────────────────────▼─────────────────┐
│                     控制面与 API 网关 (FastAPI / Uvicorn)                   │
│         Redis 会话状态同步与滑动窗口限流 │ Prometheus 指标采集 (/metrics)    │
└───────┬──────────────────────────┬───────────────────────────┬─────────────┘
        │ AsyncPG                  │ Boto3 / S3                │ Docker SDK / RPC
┌───────▼──────────┐     ┌─────────▼──────────┐     ┌──────────▼─────────────┐
│  PostgreSQL 16   │     │   MinIO 对象存储    │     │  Quest 隔离沙箱容器池   │
│ 元数据与任务账本  │     │ PDF / 权重 / 图表  │     │ Python Daemon + MCP 栈 │
│                  │     │                    │     │ memory/artifact/bash   │
└──────────────────┘     └────────────────────┘     └────────────────────────┘
- 前端协同与交互层(Next.js 15 + React 18 + TypeScript):承载富文本论文协同(Tiptap 2 + Yjs CRDT)、代码编辑(Monaco Editor)、知识图谱/任务流可视化(React Flow + Dagre)以及容器内终端与桌面直连(XTerm.js WebGL + noVNC)。
- 异步控制面与状态层(FastAPI + PostgreSQL 16 + Redis + MinIO):通过 SQLAlchemy 2.0 Async + AsyncPG 承载非阻塞元数据读写;利用 Redis 维护分布式会话缓存、Agent 运行态锁与接口限流;通过 MinIO 剥离大体积 PDF、实验产出图表与检查点文件。
- Agent 运行时与容器沙箱层(Python Daemon + MCP + Docker SDK):采用“一题一仓库(One-Quest-One-Repo)”的持久化工作区模型,在隔离容器中运行 Python 守护进程与 MCP 工具链,支持 Copilot(人机协同) 与 Autonomous(全自主长程探索) 双模式无缝续接。
二、Agent 运行时:超 100K 长上下文、双模切换与 MCP 协议栈#
在长周期科研任务中,智能体面临的最大挑战是上下文膨胀导致的注意力退化与跨轮状态丢失。如果每次工具调用都把完整的终端输出、文献全文与历史对话原封不动塞回上下文,即使接入支持 128K~200K 上下文的模型(如 GLM-4.7、Claude 等),也会在十余轮实验后触发上下文溢出或指令遵循能力下降。
1. 一题一仓库(Quest)持久化状态与 JSONL 事件流回放#
DeepScientist 将每一个科研课题抽象为一个独立的 Quest 仓库。Agent 在推进课题时的每一次思考(Thought)、工具调用(Tool Call)、标准输出截断摘要(Observation Digest)以及产出的中间产物(Artifact),都会以追加写(Append-only)方式落盘为结构化 events.jsonl 事件流:
{"seq": 42, "ts": "2026-02-14T10:15:32Z", "mode": "autonomous", "type": "tool_call", "tool": "mcp.bash_exec", "args": {"cmd": "pytest tests/test_ routing.py -q"}}
{"seq": 43, "ts": "2026-02-14T10:15:36Z", "mode": "autonomous", "type": "tool_result", "status": "ok", "exit_code": 0, "stdout_preview": "12 passed in 3.14s", "artifact_ref": "logs/run_42.log"}
这种事件溯源(Event Sourcing)设计带来了两个关键工程收益:
- Copilot / Autonomous 双模无缝续接:当用户在前端将任务从 Autonomous(后台自主跑实验)暂停并切入 Copilot(人工介入修改代码或调整实验超参)时,运行时只需读取最新的仓库工作树快照与
events.jsonl尾部窗口,即可在零状态丢失的前提下重建上下文; - 断线重连与时间旅行回放:前端页面刷新或网络抖动重连时,通过指定最后收到的
last_event_seq,后端可直接从 JSONL 偏移量增量补推缺失事件。
2. 模块化 Skill 与三类核心 MCP 工具栈#
为了统一管理模型对环境的操作边界,运行时基于 MCP(Model Context Protocol) 将底层能力抽象为三组正交的原语服务器,并配合按需挂载的本地 SKILL.md 技能描述:
| MCP 模块 | 核心原语 | 职责与上下文保护机制 |
|---|---|---|
memory | read_memory / write_memory / search_notes | 维护课题级结构化研究笔记(实验假设、已验证结论、失败归因),将跨轮关键结论从易失的对话窗口沉淀到持久化记忆文件,支撑 100K+ Token 长程状态保持。 |
artifact | register_artifact / inspect_artifact / diff_version | 追踪实验生成的数据集、折线图、SVG 插图与 LaTeX 稿件版本,在上下文中仅传递轻量级 URI 与结构化摘要,避免二进制或超长文本污染 Prompt。 |
bash_exec | run_command / check_process / kill_process | 在隔离容器内执行数据处理与模型训练脚本,内置超时熔断、退出码捕获与标准输出头尾截断(Head/Tail Truncation),完整日志自动转存为 Artifact。 |
三、双流通信架构:SSE 增量推理流与 WebSocket 交互流#
AI 科研工作台同时存在两种截然不同的实时通信负载:单向高频的 LLM 流式推理/工具状态推送,以及双向低延迟的终端交互与多人文档协同。如果在同一个通道里混用,极易出现队头阻塞或重连状态机混乱。因此我们在协议层做了严格分流:
[LLM 推理 & MCP 工具状态] ──► FastAPI StreamingResponse (SSE) ──► 前端增量状态机 (EventSource)
[容器交互终端 & 多人协同] ──► WebSocket / Socket.IO 网关       ──► XTerm.js / Yjs CRDT 文档树
- SSE(Server-Sent Events)承载超 100K Token 流式推理事件:
针对 LLM 的思维链增量输出(
delta_reasoning)、正文流(delta_content)及并发 Tool-use 状态跃迁(tool_start→tool_stdout_chunk→tool_end),采用 HTTP 原生text/event-stream。相比 WebSocket,SSE 天然兼容标准 HTTP 反向代理与鉴权中间件,且在单向流式推送场景下协议开销更低、断线自动重连语义更清晰。 - WebSocket 承载交互式 PTY 终端与 Yjs CRDT 协同:
- 容器终端直连:前端 XTerm.js(开启 WebGL 渲染加速)通过 WebSocket 挂载到沙箱容器的伪终端(PTY),结合 noVNC 支持用户在浏览器内直接接管 AI 正在操作的 Linux 桌面或交互式调试会话;
- 多人实时文档协同:富文本编辑器基于 Tiptap 2(ProseMirror)+ Yjs CRDT 构建。多端并发编辑论文或实验报告时,Yjs 利用无冲突复制数据类型(State Vector 增量交换)通过 Socket.IO 广播合并,无需中心化悲观锁即可保证强最终一致性。
四、高并发后端与容器沙箱基础设施#
1. Docker SDK 动态沙箱编排与资源隔离#
每个用户的自主实验都在独立的 Docker 容器中运行,由后端通过 Python docker SDK 按需拉起、配额限制与生命周期回收:
import docker

client = docker.from_env()

def provision_quest_sandbox(quest_id: str, workspace_host_path: str) -> dict:
    container = client.containers.run(
        image="deepscientist-sandbox:latest",
        detach=True,
        name=f"ds-sandbox-{quest_id}",
        volumes={workspace_host_path: {"bind": "/workspace", "mode": "rw"}},
        ports={"5900/tcp": None},     # 动态映射宿主机 VNC 端口
        mem_limit="4g",               # Cgroups 内存硬限制,防止实验脚本 OOM 拖垮宿主机
        cpu_period=100000,
        cpu_quota=100000,             # 限制单容器 CPU 核数配额
        network="deepscientist-sandbox-net",
        security_opt=["no-new-privileges:true"],
    )
    container.reload()
    host_port = container.ports["5900/tcp"][0]["HostPort"]
    return {"container_id": container.id, "vnc_port": host_port}
配合 Redis 维护的沙箱心跳租约(Lease TTL),当会话闲置超时或任务正常归档后,后台巡检协程自动回收容器并释放宿主机端口与内存,而 /workspace 下的代码与实验产物仍保留在持久化卷中,下次唤醒可在秒级恢复现场。
2. 异步数据层:PostgreSQL 16 + SQLAlchemy 2.0 Async + MinIO#
由于后端同时维持大量长连接(SSE 推理流)与高频事件写入,任何同步阻塞 I/O 都会直接卡死 ASGI 事件循环。数据层采用全异步栈:
- SQLAlchemy 2.0 Async + AsyncPG:使用纯异步驱动与连接池(
pool_size=20, max_overflow=10, pool_recycle=1800)管理用户、课题状态机与审计日志;利用 PostgreSQL 原生JSONB索引存储异构的 MCP 工具调用元数据。 - 元数据与大对象分离(MinIO S3):PostgreSQL 仅存储对象键(Object Key)、SHA-256 校验和与字节大小;上传的原始论文 PDF(由 MinerU / PyMuPDF 解析版面锚点)、生成的 SVG/PNG 插图(CairoSVG)与汇报幻灯片(python-pptx)全部通过预签名 URL 直传或异步写入 MinIO。
3. 可观测性与生产监控(Prometheus + Redis 限流)#
为保障 7,000+ 用户规模下的服务稳定性,后端接入了完整的指标暴露与保护链路:
- Redis 分布式状态与限流:利用 Redis Lua 脚本实现用户级与 IP 级滑动窗口速率限制(Rate Limiting),并在多 Gunicorn/Uvicorn Worker 进程间同步活跃 Agent 任务的取消信号(Cancellation Token);
- Prometheus 全链路监控:通过
/metrics端点暴露 HTTP 接口延迟直方图(P50/P95/P99)、活跃 SSE 流连接数、LLM Token 吞吐率(由tiktoken实时计量)以及沙箱容器池水位,配合 Grafana 实现异常告警。
五、核心架构设计复盘#
回顾 DeepScientist 从原型走向 7,000+ 真实科研用户的演进过程,最关键的三条工程经验是:
- 长程 Agent 的瓶颈不在单次 Prompt,而在外部化状态管理:试图把所有历史都留在 LLM 的消息数组里必然导致上下文腐化。通过“Quest 仓库文件树 +
events.jsonl事件流 + MCPmemory/artifact结构化读写”,让模型像人类研究者一样把中间结论写进笔记、把大图大表存成文件,才能稳定支撑 100K+ Token 的长周期科研闭环。 - 流式推理通道与交互式控制通道必须物理解耦:用 SSE 负责单向、高吞吐、可按序号断点续传的推理事件流,用 WebSocket 负责双向 PTY 终端与 CRDT 协同,能显著降低网关层的状态复杂度。
- 沙箱环境既要“随用随毁”又要“状态不丢”:将计算容器(无状态、受 Cgroups 严格配额限制、空闲即销毁)与课题工作区卷(持久化代码、依赖缓存与事件日志)分离,是在有限服务器资源下支撑高并发 Agent 执行的关键。
评论
评论由 GitHub Discussions 驱动,使用 GitHub 账号登录即可留言。