
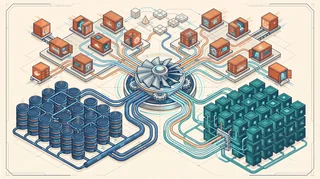
结合 DeepScientist 生产级 AI 科研平台(服务 7,000+ 用户)的实际工程落地,本文系统拆解支撑高并发流式推理与容器沙箱调度的后端基础设施栈——FastAPI(ASGI 异步网关 + SSE 流式推送)、SQLAlchemy 2.0 Async + AsyncPG、PostgreSQL 16 + MinIO 存储分层与 Docker SDK 动态容器编排的职责边界与关键实现细节。
FastAPI#
为什么选它#
Python Web 框架的选择通常是 Django / Flask / FastAPI 三选一。
| 框架 | 异步支持 | 自动文档 | 适合场景 |
|---|---|---|---|
| Django | 有限 | 需插件 | 全功能 Web 应用,内置 ORM/Admin |
| Flask | 需扩展 | 需插件 | 轻量 API,灵活但需要自己组装 |
| FastAPI | 原生 | 自动生成 | I/O 密集型 API 服务 |
FastAPI 的核心优势:
1. 原生 async/await
@app.get("/papers/{paper_id}")
async def get_paper(paper_id: int, db: AsyncSession = Depends(get_db)):
    result = await db.execute(select(Paper).where(Paper.id == paper_id))
    return result.scalar_one_or_none()
函数加 async,数据库查询加 await,FastAPI 自动在 ASGI 事件循环里调度。
2. Pydantic 自动校验
class PaperCreate(BaseModel):
    title: str
    abstract: str
    year: int = Field(ge=1900, le=2100)

@app.post("/papers/")
async def create_paper(paper: PaperCreate):
    # 进到这里参数已经校验过了,year 一定在 1900-2100 之间
    ...
请求体自动解析 + 类型校验 + 错误信息生成,一行代码都不用多写。
3. 自动生成 OpenAPI 文档
启动后访问 /docs 就有交互式 API 文档,前端联调不需要手写文档。
SSE 流式返回#
DeepScientist 的 AI Copilot 用 SSE(Server-Sent Events)实现流式输出:
from fastapi.responses import StreamingResponse

async def generate_stream(prompt: str):
    async for chunk in llm_client.stream(prompt):
        yield f"data: {chunk}\n\n"

@app.post("/copilot/chat")
async def chat(request: ChatRequest):
    return StreamingResponse(
        generate_stream(request.message),
        media_type="text/event-stream"
    )
前端用 EventSource 或 fetch + ReadableStream 接收,实现打字机效果。
SQLAlchemy async + AsyncPG#
为什么 async 很重要#
FastAPI 是 ASGI 框架,底层是一个事件循环(event loop)。如果用同步数据库驱动:
请求 A 进来 → 查数据库(同步,阻塞 200ms)
                ↑ 这 200ms 里事件循环被占用,请求 B 只能等
换成 async:
请求 A 进来 → 发出数据库查询(异步,挂起)
              ↓ 事件循环空闲,处理请求 B
              ↓ 数据库返回结果,恢复请求 A
相同硬件,async 模式下并发能力可以提升数倍。
实际写法#
# 配置异步引擎
from sqlalchemy.ext.asyncio import create_async_engine, AsyncSession

engine = create_async_engine(
    "postgresql+asyncpg://user:pass@localhost/dbname",
    pool_size=20,
    max_overflow=10,
)

# 查询
async with AsyncSession(engine) as session:
    # 单条查询
    user = await session.get(User, user_id)

    # 条件查询
    result = await session.execute(
        select(Paper)
        .where(Paper.user_id == user_id)
        .order_by(Paper.created_at.desc())
        .limit(20)
    )
    papers = result.scalars().all()

    # 写入
    session.add(Paper(title="...", user_id=user_id))
    await session.commit()
Alembic 数据库迁移#
修改 Model 之后不能直接改数据库,要走迁移:
# 自动生成迁移脚本(对比 Model 和数据库现状)
alembic revision --autogenerate -m "add paper table"

# 执行迁移
alembic upgrade head

# 回滚一步
alembic downgrade -1
迁移脚本会记录在 alembic/versions/ 里,可以 git 追踪,团队协作时每个人 upgrade head 就能同步数据库结构。
PostgreSQL#
为什么不用 MySQL#
两者都是成熟的关系型数据库,但 PostgreSQL 在以下场景更强:
| 特性 | PostgreSQL | MySQL |
|---|---|---|
| JSON/JSONB 字段 | 原生支持,可索引 | 支持但较弱 |
| 全文搜索 | 内置 tsvector | 需要插件 |
| 复杂查询 | CTE、窗口函数更完善 | 部分支持 |
| 扩展生态 | pgvector(向量搜索)等 | 较少 |
DeepScientist 用 PostgreSQL 存所有结构化数据,二进制文件(PDF、图片)存 MinIO,数据库只存路径和元数据。
文件存储原则#
❌ 错误做法:把 PDF 二进制存进数据库
   → 表体积膨胀,备份困难,无法 CDN 加速

✅ 正确做法:
   上传 PDF → FastAPI → MinIO(存文件)
                      → PostgreSQL(存路径、大小、MIME 类型)

   下载 PDF → FastAPI → PostgreSQL(查路径)
                      → MinIO(取文件)→ 返回客户端
连接池#
生产环境不能每次请求都新建数据库连接(开销大),要用连接池:
engine = create_async_engine(
    DATABASE_URL,
    pool_size=20,        # 常驻连接数
    max_overflow=10,     # 峰值时额外允许的连接数
    pool_timeout=30,     # 等待连接超时时间(秒)
    pool_recycle=1800,   # 连接复用超过 30 分钟就重建(防止数据库断开)
)
Docker#
基本概念#
- 镜像(Image):只读模板,类似类定义
- 容器(Container):镜像的运行实例,类似对象实例
- Dockerfile:描述如何构建镜像的脚本
DeepScientist 的 FastAPI Dockerfile:
FROM python:3.11-slim

WORKDIR /app

# 先复制依赖文件,利用 Docker 层缓存
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

COPY . .

CMD ["uvicorn", "main:app", "--host", "0.0.0.0", "--port", "18080"]
Docker Compose 服务编排#
services:
  frontend:
    build: ./frontend
    ports: ["1288:3000"]
    depends_on: [backend]

  backend:
    build: ./backend
    ports: ["18080:18080"]
    environment:
      DATABASE_URL: postgresql+asyncpg://postgres:pass@postgres/deepscientist
    depends_on: [postgres, minio]

  postgres:
    image: postgres:16
    volumes:
      - postgres_data:/var/lib/postgresql/data
    environment:
      POSTGRES_PASSWORD: pass
      POSTGRES_DB: deepscientist

  minio:
    image: minio/minio
    ports: ["9000:9000", "9001:9001"]
    command: server /data --console-address ":9001"
    volumes:
      - minio_data:/data

  sandbox:
    image: deepscientist-sandbox
    ports: ["15900-15901:5900-5901"]  # VNC

volumes:
  postgres_data:
  minio_data:

networks:
  default:
    name: deepscientist-network
服务间通过容器名互相访问(postgres、minio),不需要硬编码 IP。
用 Docker SDK 动态管理容器#
DeepScientist 的 AI 沙箱不是固定的,而是按需创建:
import docker

client = docker.from_env()

def create_sandbox(user_id: str) -> str:
    container = client.containers.run(
        "deepscientist-sandbox",
        detach=True,
        name=f"sandbox-{user_id}",
        ports={"5900/tcp": None},   # 随机分配宿主机端口
        mem_limit="2g",
        cpu_period=100000,
        cpu_quota=50000,            # 限制 50% CPU
        network="deepscientist-network",
    )
    # 获取实际分配的端口
    port = client.containers.get(container.id).ports["5900/tcp"][0]["HostPort"]
    return port

def destroy_sandbox(user_id: str):
    try:
        container = client.containers.get(f"sandbox-{user_id}")
        container.stop()
        container.remove()
    except docker.errors.NotFound:
        pass
用户退出时调用 destroy_sandbox,资源立即释放。
Docker vs Kubernetes#
面试常问:
| Docker Compose | Kubernetes | |
|---|---|---|
| 适合规模 | 单机 / 小团队 | 多节点集群 |
| 学习成本 | 低 | 高 |
| 自动扩缩容 | 不支持 | 支持 |
| 服务发现 | 容器名 | DNS + Service |
| 适合场景 | 开发环境、小型生产 | 大规模生产 |
DeepScientist 目前用 Compose,够用。如果用户量上去了,迁移到 K8s 的成本也不高,因为 Compose 和 K8s 的概念是对应的。
面试常见问题#
Q:FastAPI 和 Flask 的区别?
FastAPI 原生 async,性能接近 Node.js;Pydantic 自动校验省去大量手写代码;自动生成 OpenAPI 文档。Flask 更灵活但需要自己组装异步支持和校验逻辑。I/O 密集型 API 服务首选 FastAPI。
Q:SQLAlchemy ORM 和原生 SQL 怎么选?
简单 CRUD 用 ORM,开发快、类型安全。复杂查询(多表 JOIN、窗口函数、批量操作)用原生 SQL 或 text(),性能更可控。两者可以混用,SQLAlchemy 支持直接执行原生 SQL。
Q:数据库连接池的作用?
建立数据库连接有握手开销(TCP + 认证),每次请求都新建连接会很慢。连接池维护一组复用的连接,请求来了直接取,用完归还,避免重复建连开销。
Q:Docker 容器和虚拟机的区别?
虚拟机模拟完整硬件,有独立 OS,隔离性强但开销大(GB 级镜像,秒级启动)。容器共享宿主机内核,只隔离进程和文件系统,镜像小(MB 级),启动毫秒级。容器不是完全隔离的,安全敏感场景还是用 VM。
Q:depends_on 能保证服务启动顺序吗?
只能保证容器启动顺序,不能保证服务就绪。PostgreSQL 容器启动了不代表数据库已经可以接受连接。生产环境要在应用代码里加重试逻辑,或者用 healthcheck + condition: service_healthy。
评论
评论由 GitHub Discussions 驱动,使用 GitHub 账号登录即可留言。